Disclaimer: Quanto segue va preso null'altro che come esercizio di stile e per la materia stessa trattata (statistica inferenziale) non è concepito per distribuire certezze

Per persone che, come il sottoscritto, si trova continuamente ad avere a che fare con numeri, la lettura del rapporto di servizio 2021 da più o meno l'effetto del sibilo del gessetto strisciato sulla lavagna o quella che potrebbe avere la lettura della Divina Commedia riscritta in dialetto sardo.
la tabellina dei totali per paese da l'idea "a pelle" di qualcosa di errato, specie se si considerano gli andamenti anno su anno recenti e remoti; c'è qualcosa che non funziona, una sensazione di sbagliato e fuori posto tipo un gelato limone e cioccolato.
Quindi ho provato a giocare con alcuni comuni algoritmi che si utilizzano per valutare frodi e manipolazioni su serie di dati; uno dei più comuni e semplici (anche per la ridotta mole di dati da verificare) si basa sulla legge di Benford
Quanto segue rischia di essere parecchio noioso, quindi la faremo breve e mi scuso in anticipo qualora la necessità di ipersemplificazione a volte vada a scapito del rigore
Tutto quanto è inteso come integrazione al post di Capitan Kirk
La legge di Benford
Qualcuno "empiricamente" ha forse notato come appare più probabile che un numero casuale inizi con la cifra 1.
La cifra 1 infatti NON ha la stessa probabilità di essere una cifra iniziale di un numero appartenente ad una distribuzione di rilevazioni di quanto non lo siano ad esempio il 9, 8 o 5.
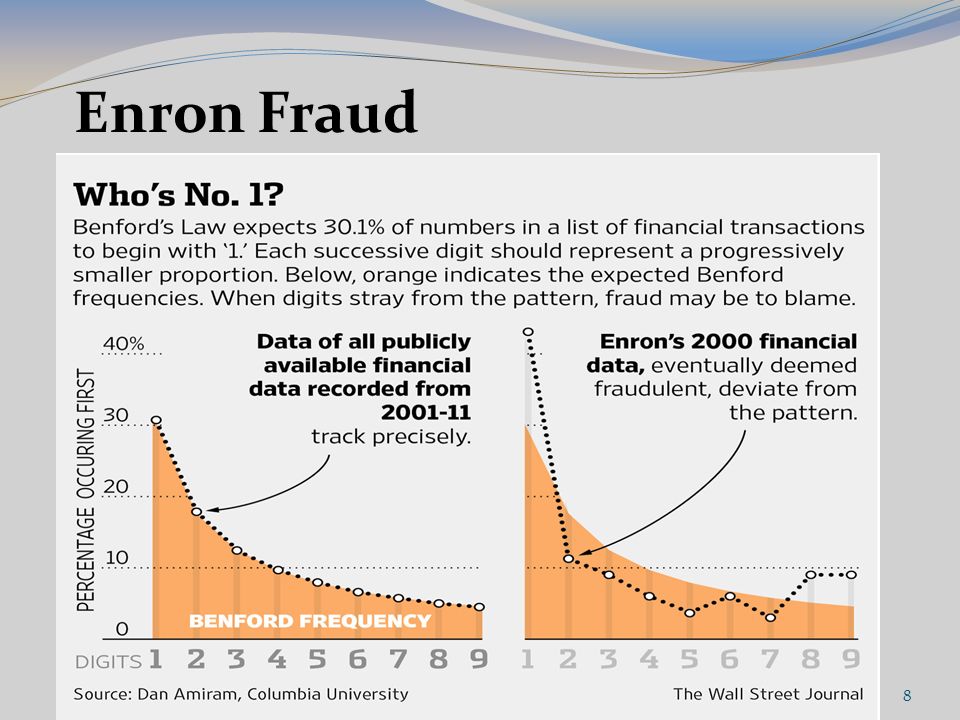
Secondo la legge di Benford (Legge della prima cifra) la frequenza dell' occorrenza delle cifre iniziali nelle distribuzioni numeriche naturali è
prevedibile e
non uniforme e assimilabile a un
andamento in decadimento logarimico.
In effetti, un numero sempre appartenente alla nostra distribuzione di rilevazioni casuali ha 6 volte la probabilità di iniziare con un 1 rispetto a 9.
Questo fatto controintuitivo e apparentemente molto illogico; la maggior parte delle persone si aspetterebbe una distribuzione uniforme in cui tutte le cifre hanno la stessa probabilità di apparire nel primo "posto"; ci ai aspetterebbe quindi una probabilità di 1/9 e cioè, vuoto per pieno, circa 11,1%.
Consideriamo che Pr(D1=d) è la probabilità che un dato numero abbia la prima cifra d e la Pr(D2=d) le prime due cifre, la tabella seguente fornisce tutti i problemi di cifre decimali emersi dall'osservazione di Newcomb nel 1881 .
Newcomb notò come le pagine relative alle tavole dei logaritmi, le pagine aventi "1" quale prima cifra fossero molto più sporche delle altre, forse perché usate più spesso. L'argomentazione era in se debolissima perché generalmente si accede / legge un libro in modo "sequenziale", dall'inizio alla fine quindi va da se che le prime pagine siano più rovinate. L'argomentazione era così debole che si ritiene che la storia sia solo un aneddoto.
Nel 1938, il fisico Frank Benford riscoprì il teorema di Newcomb raccogliendo oltre 20.000 campioni di numeri del mondo reale, utilizzando fonti di dati distinte come le misurazioni di lunghezze dei fiumi, indirizzi stradali, numeri contenuti nella rivista Reader's Digest, pesi molecolari, statistiche sul baseball. , tassi di mortalità e altro ancora in un pool di datasets eterogeneo.
Siccome ha reso popolare questa scoperta scientifica, se ne è poi attribuito tutto il merito dando il proprio nome alla legge.
Secondo Benford, un modello aneddotico che emerge in insiemi di dati così apparentemente disparati con la cifra iniziale, "n", in quei set di dati che seguono una distribuzione logaritmicamente in decadimento:
Modellizzazione intuitiva
Un campo importante che è l'applicazione più nota della legge di Benford era la modellizzazione intuitiva. Si parte da un assunto semplice: se un certo insieme di valori segue la legge di Benford, anche i modelli per i corrispondenti valori previsti dovrebbero seguire la legge di Benford.
Può essere utilizzato in modelli per la crescita demografica, indici finanziari, e qualsiasi set di dati Benford ed usato quindi per
rilevamento frodi: I dati manipolati o fraudolenti
non tendono a confermare la legge di Benford, mentre i dati non manipolati sì; ovviamente stiamo semplificando.
Con la dichiarazione di cui sopra, la legge di Benford può essere dichiarata una regola importante per indagare sui modelli di frode per i set di dati in campi in cui sono stati conteggiati valori categorici, come entrate fiscali, rimborsi ai clienti, incidenze nelle popolazioni, crescita delle popolazioni ecc.
Quello sotto è un esempio della deriva del dataset delle transazioni Enron, che si scoprì poi più taroccato di una borsa Luis Vuitton comperata da un bengalese in una spiaggia di Fiumicino.
La Enron fallì.
Gli stessi pattern emergono coi dati finanziari di altri grossi crack, con i dati delle elezioni russe mentre quelli relativi alla vittoria di Trump sono al limite.
Tuttavia non si può escludere che dati che non rispettino tale legge siano comunque stati soggetti a "document & data forgery"; su alcune serie di dati semplicemente è inapplicabile.
Veniamo al dunque
Proviamo quindi ad applicare un "semplice" test di rilevamento frode sul rapporto annuale 2021, specie per le due variabili che più "stonano", ovvero il numero dei proclamatori medio e massimo
Ipotesi - premesse1. I numeri devono essere casuali e non assegnati, senza minimi o massimi imposti: il set di dati in esame rispetta questo criterio
2. I numeri dovrebbero coprire diversi ordini di grandezza e il set di dati dovrebbe essere grande; le raccomandazioni in letteratura richiedono da 100 a 1.000 campioni come minimo, sebbene sia stato dimostrato che la legge di Benford è vera per set di dati contenenti solo 50 numeri. Il set di dati in esame rispetta questo criterio; non è grandissimo, raccogliendo circa 450 campioni (proclamatori medi e massimi).
Si potrebbe obiettare che duplicando di fatto dati simili su un unica serie potrebbero esasperarsi eventuali pattern propri dei dati, ne terremo conto in un test controfattuale separando le due serie
Test del chi-quadratoIl test della validità di adattamento che viene comunemente utilizzato per effettuare la simulazione con la legge di Benford è il test
Chi-quadrato; è un metodo frequentemente utilizzato che determina se una distribuzione empirica (osservata) differisce significativamente da una distribuzione teorica (prevista) e per decidere se rifiutare o non rifiutare l'
ipotesi nulla.
Viene utilizzato un livello di significatività (p-value) pari a 0,05 che considera un margine un errore del 5%.
La distribuzione ha 9 categorie, quindi 8 gradi di libertà; il valore critico per accettare o rifiutare l'ipotesi nulla è di 15.51, più basso il valore migliore è la significatività
risultati sui dati 2021:
1) stante al test Chi quadrato abbiamo una probabilità parecchio inferiore al 5% (meno del'1%) che la combinazione di frequenze nelle categorie di dati si sia prodotto in modo casuale relativamente all'aggregato dei due campioni (media anno e massimo anno) mentre e inferiore al 5% (circa il 3%) considerando le singole serie separatamente
- dato aggregato: chi^2 = 34,6 - limite: 15,51 (probabilità si sia verificato casualmente: meno del'1%)
- serie separate - max proclamatori: chi^2 = 16.3 (probabilità si sia verificato casualmente: 3-4%)
- serie separate - media proclamatori: chi^2 = 16.9 (probabilità si sia verificato casualmente: 2-3%)
2) gli altri dati riportati nella tabella (popolazione, studi biblici, numero battezzati ecc) rispettano la legge di Bendford, compresi i presenti alla commemorazione, seppure in modo più "tirato". Questo a mio modo di vedere è una anomalia ulteriore. Lasciamo stare le ore di servizio che sono fuffa pura, anche se la somma degli errori potrebbe tendere a zero in termini di anomalia della distribuzione Benford.
Manipolazione dei numeri?
Metodi simili di "fraud detection" non hanno il compito di fornire o produrre certezze ma quello di "accendere la spia nel cruscotto" e mettere la pulce nell'orecchio.
Una ulteriore analisi può essere condotta sulla sequenza storica recente per valutare se questo è un pattern comune oppure vi sia la tendenza ad una deriva verso una sempre minore
significatività statistica
risultati sui dati 2020:
- dato aggregato: chi^2 = 28,5 - limite: 15,51 (probabilità si sia verificato casualmente: meno del'1%)
- serie separate - max proclamatori: chi^2 = 14,9 (siamo al limite per rifiutare l'ipotesi nulla)
- serie separate - media proclamatori: chi^2 = 15,8 (probabilità si sia verificato casualmente: circa 4%)
1) stante al test Chi quadrato abbiamo una probabilità parecchio inferiore al 5% (meno del'1,5%) che la combinazione di frequenze nelle categorie di dati si sia prodotto in modo casuale relativamente all'aggregato dei due campioni (media anno e massimo anno) e inferiore al 5% (circa il 3%) considerando le singole serie separatamente. Il livello di significatività, seppur bassissimo,
è superiore a quello del 20212) gli altri dati riportati nella tabella (popolazione, studi biblici, numero battezzati ecc) rispettano la legge di Bendford, compresi i presenti alla commemorazione
risultati sui dati 2019:
- dato aggregato: chi^2 = 29,8 - limite: 15,51 (probabilità si sia verificato casualmente meno del'1%)
- serie separate - max proclamatori: chi^2 = 15,2 (siamo al limite per rifiutare l'ipotesi nulla)
- serie separate - media proclamatori: chi^2 = 15,4 (siamo al limite per rifiutare l'ipotesi nulla)
Su questi mi attendevo un leggero peggioramento della significatività rispetto all'anno successivo e precedente, essendoci, in questo rapporto evidenti presenze di dati "proxy" ovvero calcolati sulla base di altri dati all'interno del perimetro "numero di proclamatori"
1) stante al test Chi quadrato per dati aggregati abbiamo una probabilità parecchio inferiore al 5% (meno del'1%) che la combinazione di frequenze nelle categorie di dati si sia prodotto in modo casuale relativamente
2) gli altri dati riportati nella tabella (popolazione, studi biblici, numero battezzati ecc) rispettano la legge di Bendford, compresi i presenti alla commemorazione
risultati sui dati 2018:
- dato aggregato: non verificabile, mancano i dati di media proclamatore
- serie separate - max proclamatori: chi^2 = 12,8 (valore accettabile)
- serie separate - non verificabile, mancano i dati di media proclamatore
Gli altri dati riportati nella tabella (popolazione, studi biblici, numero battezzati ecc) rispettano la legge di Bendford
risultati sui dati 2017:
Qui c'è molto probabilmente l'effetto di contabilità creativa specie nel continente Africano, dove iniziavano le mirabolanti bolle di crescita che si sarebbero poi sgonfiate in era covid.
- dato aggregato: non verificabile, mancano i dati di media proclamatore
- serie separate - max proclamatori: chi^2 = 15,8 (probabilità si sia verificato casualmente: circa 4%)
- serie separate - non verificabile, mancano i dati di media proclamatore
Conclusioni:
Di fronte a dati simili, chi dovesse essere nella posizione di dover condurre analisi per fraud detection accenderebbe qualche campanello di allarme e inizierebbe ad andare più a fondo. Peccato che qui non si possa fare visto che la gran parte del dato fornito al pubblico è "garbage"
In ogni caso è molto probabile che i totali e le medie dei proclamatori siano da tempo oggetto di operazioni cosmetiche che si vanno via via affastellando l'una sull'altra togliendo gradualmente significatività ai numeri e alle serie storiche.
Al momento mi sono fermato alle annate che è facile analizzare mediante un semplice web scraping e non ho intenzione di perder tempo a convertire pdf confezionati in modo escrementizio relativi alle annate precedenti. I gatti per natura sono pigri.
Se qualcuno ha voglia di convertirseli in csv o excel sono lieto di analizzarli, anche perché ad occhio più si va indietro nel tempo e più i rapporti paiono coerenti.